ÜBER SPRACHE

Posts mit dem Label Schriftsysteme werden angezeigt. Alle Posts anzeigen

Mittwoch, 18. März 2015

Das Uighuische und seine Schriften

Das Uighurische ist eine Turksprache Zentralasiens, die überwiegend in der östlichsten Provinz Chinas, Xinjiang gesprochen wird. Sie wird von über zehn Millionen Menschen gesprochen. Bekannt sind die Uighuren nicht nur durch ihre Unabhängigkeitsbestrebungen, sondern auch durch die Hinterlassenschaften des uighurischen Reiches, das in Städten wie Kashgar und Turfan den Seidenstraßenhandel ermöglicht hat und die Region entscheidend kulturell geprägt hat.
Auch wenn eine direkte Abstammung der Sprache und des Volkes von den gleichnamigen Äquivalenten des uighurischen Reiches eher auszuschließen ist, werden wir uns hier die verschiedenen Verschriftlichungen beider Sprachen über die Zeit anschauen.

Einige der ältesten gefundenen Schriftzeugnisse sind in den sogenannten Orchon-Runen geschrieben. Diese Buchstabenschrift, die den germanischen Runen erstaunlich ähnlich sieht, stammt wahrscheinlich vom aramäischen Alphabet ab und wurde speziell für die Verschriftlichung von Turksprachen modifiziert. Später, als die Uighuren sesshaft wurden und ihre städtische Kultur im heutigen Xinjiang entwickelten, kamen Sie in Berührung mit der sogdischen Schrift, die in dieser Epoche sehr verbreitet in Zentralasien war. Aus der Zeit sind einige Werke verschiedener Religionen erhalten. Sowohl buddhistische, als auch verschiedene Schriftstücke christlicher Konfessionen wurden im Reich der Uighuren verfasst. Die sogdische Schrift wurde früh modifiziert und ihre neue Version nannte man ab sofort die uighurische Schrift.
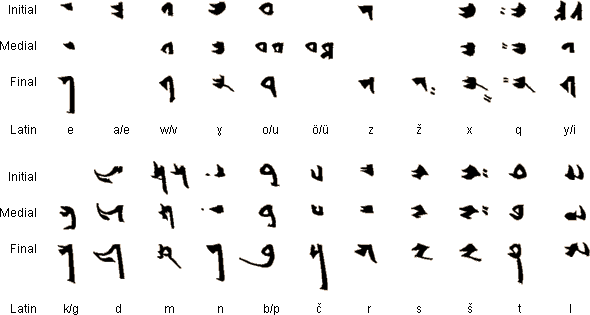
Alt-uighurische Schrift. Quelle: wikipedia
Nach chinesischem Vorbild wurde sie später von oben nach unten geschrieben und bildete die Grundlage der Schriften von anderen Völkern der Region, wie den Mongolen und den Mandschu. Dies blieb jedoch vorerst der einzige Einfluss der chinesischen Schrift auf die uighurische Schrift, denn sie war und ist denkbar ungeeignet, um mit ihr andere Sprachen zu verschriftlichen – vor allem Sprachen, die eine Vielzahl von Silbenformen aufweisen.

Mit dem Beginn der Islamisierung im zehnten Jahrhundert n. Chr. wurde die arabische Schrift immer populärer, sodass sie bis Mitte des 20sten Jahrhunderts das einzige Alphabet in Gebrauch war. Ihre Buchstaben wurden der uighurischen Schrift angepasst, um alle Phoneme und vor allem das größere Vokalinventar als das des Arabischen darstellen zu können. 

All diese Schriften hatten eindeutig ihren Ursprung im Nahen Osten. Eine ganz andere Epoche beginnt durch den Sieg der kommunistischen Partei in China und dadurch der Gründung der Volksrepublik China. Im Zuge von Massenalphabetisierung und Vereinheitlichung der Schriftsysteme werden einige aufeinanderfolgende Reformen beschlossen, die im Falle des Uighurischen eher  für Verwirrung sorgten und im Nachhinein als gescheitert betrachtet werden können. In den 50er Jahren manifestierte sich die guten sowjetisch-chinesischen Beziehungen in einer kyrillischen Schriftreform nach dem Vorbild der Sowjetunion. Die kyrillische Schrift sollte zwar in ganz Xinjiang für das Uighurische und einige andere Turksprachen durchgesetzt werden, jedoch überschattete schon ein Jahr später ein neues  Projekt die Bemühungen: Nach der Einführung der offiziellen chinesischen Umschrift „Hanyu Pinyin“ sollten nun möglichst viele Minderheitensprachen nach demselben Muster verschriftlicht werden. Folgend wurde also auch für das Uighurische eine Romanisierung nach dem System des „Hanyu Pinyin“ erarbeitet und wenig später propagiert. Eine Benutzung der arabischen Schrift wurde von 1960-82 verboten. Die Bevölkerung hatte die romanisierte Verschriftlichung jedoch nie völlig akzeptiert und so wurde die alte arabische Schrift in den 80er Jahren wieder erlaubt und verdrängte die Lateinschrift vollständig.


Diese Entscheidung lässt mehr Mitspracherecht der Minderheiten in China seit den 80er Jahren vermuten und ist ein Beispiel für den starken Bund zwischen Schrift und kultureller Identität.  

Donnerstag, 25. September 2014

In China wird mit Bildern geschrieben?

09:19 Posted by uebersprache , , , 1 comment
Dieser Mythos scheint sich immer noch zu halten…  – Kein Wunder, wenn man von der Presse auch so schöne Beispiele wie: – mù (Baum) oder – yuè (Mond) vorgesetzt bekommt, die in älteren Formen sogar noch wie ein Baum und ein Mond aussahen. Diese Zeichen sind in gewisser Weise Bilder – sogenannte Piktogramme. Aber kann man eine ganze Sprache nur in Bildern schreiben?

Chinesisch in Lang- und Kurzzeichen
Quelle: Wikipedia
In der heutigen chinesischen Schrift machen diese piktographischen Zeichen, genau wie ideographische Zeichen (also Zeichen, die abstrakt auf ein Begriff verweisen wie – shàng (oben) oder - sān (drei)) jedoch einen geringen Prozentsatz aller Zeichen aus. Viel produktiver war die Methode, eine Bedeutungskomponente mit einer phonetischen Komponente zu kombinieren, sodass die Aussprache einigermaßen abgelesen werden konnte und gleichzeitig ganz grob die Semantik vorgegeben wurde. Ca. 90% der Schriftzeichen entstanden nach dieser Methode. So steht – mā zum Beispiel für Mutter und enthält die Bedeutungskomponente - nǚ (Frau) und die Aussprachekomponente – mǎ (Pferd), die semantisch offensichtlich keinen Wert hat. Auch hier sind die eigentlichen „Bilder“ noch klar zu erkennen, jedoch kann nicht behauptet werden, dass ein Zeichen ein Bild ist!
Vielmehr steht jedes chinesische Zeichen für ein Morphem, das im Mandarin-Chinesischen auch jeweils nur aus einer Silbe besteht. Daher kann man auch von einer morpho-syllabischen Schrift sprechen. Und dabei verweist das Zeichen nicht – wie oft behauptet, primär auf die Bedeutung, also auf ein Objekt oder ein Konzept, sondern wie die meisten Schriften auf eine lautliche Einheit (hier eine Silbe inklusive Ton).

Wörter werden im modernen Mandarin-Chinesisch häufig aus mehr als einem Morphem/Schriftzeichen gebildet, was auch mit der großen Anzahl an Homonymen unter diesen Morphem-Silben zusammenhängt. 

Mittwoch, 17. September 2014

Eine Schrift zum Schnellschreiben

06:05 Posted by uebersprache , 1 comment
Quelle: Wikipedia
Sehr aus der Mode gekommen, aber trotzdem ziemlich interessant: 
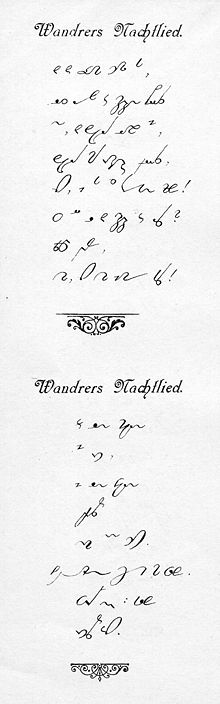
Die Stenographie.

Schon im alten Griechenland und im römischen Reich bestand anscheinend der Bedarf an einer Schrift, die mit dem natürlichen Redefluss Schritt halten konnte. Und so wurden immer kompaktere Kürzel für mehr und mehr häufig verwendete Wörter entwickelt, die im Gericht oder bei wichtigen politischen Ereignissen das protokollieren erleichterten. Das Prinzip wurde über die Jahre weiterentwickelt und so brachte Franz Gabelsberger 1834 sein „kursives“ Stenographie-System heraus, das Grundlage für die noch heute benutzten Formen ist und auf dem Prinzip der Schreibschrift basiert. – Es wird also ein Wort geschrieben ohne den Stift abzusetzen. Auch Faulmanns Phonographie, die ich hier schon erwähnt hatte, ist durch das Gabelsberger System inspiriert worden.

Wie funktioniert nun Stenographie?

Zunächst gibt es das einfache Alphabet, bei dem alle Konsonanten und häufige Konsonantenverbindungen ein Zeichen haben:


Verbindet an sie zu Wörtern, gibt die Verbindung zwischen diesen Konsonanten-Zeichen die Art des Vokals an. Dabei ist Strichdicke, Abstand und Höhe des folgenden Zeichens entscheidend. Die Dicke wird durch einen weichen Bleistift erreicht:


Zusätzlich zu diesem Alphabet können mehrere Stufen an Verkürzungen gelernt werden, die den Schreibfluss mehr und mehr erleichtern. Parlamentsstenographen, die tatsächlich den natürlichen Sprechfluss aufzeichnen können, entwickeln ihre eigenen Kürzel, um eine maximale Geschwindigkeit zu erreichen. Diese Aufzeichnungen sind daher nur persönlich zu entziffern.
Kürzel können sowohl häufig vorkommende Prä- und Suffixe, Partikel oder ganze Wörter beinhalten und sind daher sprachspezifisch zu erlernen:


An Attraktivität hat die Stenographie leider verloren, da andere digitale Aufzeichnungsmöglichkeiten die Schnellschrift ablösen und der hohe Lernaufwand nur noch selten in Kauf genommen wird. Ich hatte mir diesen Aufwand gemacht und profitiere davon vor allem beim Schreiben von Notizen und in der Universität, auch wenn ich während des Lernens früher nicht daran gedacht hatte, dass ein Großteil der Vorlesungen einmal digital aufgezeichnet werden würde.

Die Beispiele außer das erste lange Bild zeigen das System Stolze-Schrey, das noch heute in der Schweiz benutzt wird, dem aber das gleiche Prinzip wie das der deutschen Einheitskurzschrift zugrunde liegt. Für mehr Infos: Hier.


Samstag, 13. September 2014

Was spricht man eigentlich in... MYANMAR?

Man hat schon von so einigen Ländern gehört, weiß vielleicht ungefähr, wo sie liegen könnten, aber weiß man auch, was dort gesprochen wird? Meistens nicht. Auf diese Wissenslücken möchte ich gerne eingehen, indem ich in unregelmäßigen Abständen auf die Sprachsituation eines Landes oder einer Region eingehe.

Zunächst einmal sollte man sich klar machen, dass die häufig anzutreffende Idee eines Staates mit genau einer Sprache, der Idee von sogenannten Nationalstaaten, praktisch nicht existiert. Weder in Ländern, die durch die Kolonisation entstanden sind, noch hier in Europa oder woanders auf der Welt. Wer trotzdem einen Staat kennt, in dem nur eine Sprache gesprochen wird, möge mir das bitte in den Kommentaren mitteilen.

Quelle: Wikipedia
Und so wird auch in Myanmar nicht nur eine Sprache gesprochen.
Politisch gesehen gibt es nur eine Amtssprache, die auch die meistgesprochene Sprache des Landes ist: Die Sprache der Birmanen mit einer Sprecherzahl von 32 Mio. (ethnologue)
Vielleicht klingelt’s nun bei einigen, denn Myanmar ist auch unter dem Namen Burma oder Birma bekannt. Sogar ein Ast der Sino-Tibetischen Sprachfamilie (Burmesische Sprachen) ist nach dieser Ethnie benannt.
Falls einige noch immer nicht wissen, was oder wo Myanmar ist: Das Land liegt in Südost-Asien, östlich von Indien, südlich von China und westlich von Thailand. Bekannt ist das Land leider vor allem für die Militärjunta, jedoch soll es auch ein perfektes Reiseziel abgeben.
Quelle: Wikipedia

Birmanisch ist wie die meisten Sino-Tibetischen Sprachen analytisch, ist außerdem eine SOV-Sprache, hat Töne und eine eigene Schrift, die so aussieht:  မြန်မာအက္ခရာ
Die Schrift hat ihren Ursprung in der Brahmi-Schrift, aus der viele indische Schriften entstanden sind. Wie die indischen Schriften ist sie eine sogenannte Abugida, bei der jeder Konsonant, der ohne Vokalzeichen geschrieben wird, ein a gelesen wird.
Die größte Minderheit in Myanmar stellen die Shan im Osten von Myanmar dar. Anders als das Birmanische ist die Shan-Sprache eine Tai-Kadai-Sprache und damit verwandt mit dem benachbarten Thai. Sie wird von ca. 3,2 Mio. Personen gesprochen. (ethnologue)
Auch Mon-Khmer-Sprachen sind in Myanmars Osten zu finden. So sprechen zum Beispiel insgesamt über 500.000 Personen dort eine der drei Varietäten von Palaung.

Zusammen werden 117 Sprachen in Myanmar gezählt.

Freitag, 5. September 2014

Carl Faulmann und die Schrift

06:13 Posted by uebersprache , No comments
Ein ganz besonderes Buch zum Schmökern bei mir zu Hause heißt „das Buch der Schrift“ und ist ein Sammelwerk an Alphabeten. Nach kurzer Recherche fand ich heraus, dass dieses Buch, das in meinem Fall vom Flohmarkt stammt, noch immer unverändert publiziert wird. Und das, obwohl diese zweite Auflage schon 1880 veröffentlicht wurde.

Quelle: Wikipedia
Quelle: Wikipedia
Faulmann trug die Alphabete der verschiedenen Kontinente mühsam aus Fachzeitschriften, Grammatiken und Reisebeschreibungen zusammen und erreichte somit eine Vollständigkeit, die noch heute wert ist gedruckt zu werden. Besonders interessant ist das am Anfang erklärte „Standard-Alphabet“ – entwickelt von Karl Richard Lepsius zur einheitlichen Beschreibung der Laute und zum Transliterieren von Schriftsystemen. Dieses Alphabet ist also ein früher Vorläufer der IPA!
Sein eigener Beitrag ist das von ihm entwickeltes Stenographie-System „Phonographie“ Diese Schnellschrift soll erstmals komplett auf Orthographie verzichten und macht relativ feine Lautunterscheidungen.


Das Buch enthält neben den wichtigsten Alphabeten der Welt auch unbekanntere Schriften, Abkürzungen, Ligaturen und Symbole - begleitet von Kommentaren, die das Schriftsystem erklären und einen kurze Beschreibung zum Volk und zur Verwendung enthalten. So können unter anderem das griechische, armenische, amharische oder kambodschanische Alphabet, chinesische Schriftzeichen, Indische Silbenschriften, aber auch Kuriositäten wie das Mormonen-Alphabet entdeckt werden, das Faulmann sehr direkt kommentiert:

„Das obige, ganz willkürlich gebildete und speciell für die englische Sprache erfundene Alphabet hat offenbar keinen anderen Zweck, als durch die Fremdartigkeit der Zeichen die Täuschung zu verstärken, welche bei leichtgläubigen Gemüthern mit MORMON’S Buch beabsichtigt wurde.“


Ein Blick ins Buch ist auf jeden Fall zu empfehlen, weswegen dieses Fundstück auch sofort auf meine Bücherliste gesetzt wird.

Donnerstag, 28. August 2014

Wie funktionieren chinesische Wörterbücher?

02:04 Posted by uebersprache , , , No comments
Heutzutage ist das Problem gar nicht mehr so relevant, denn das Internet bietet zahlreiche online-Ressourcen, die die Suche nach chinesischen Schriftzeichen enorm erleichtern. So kann man zum Beispiel bei nciku.com mit der Maus Schriftzeichen zeichnen und dann relativ effektiv erkennen lassen.

Aber wie lief das früher? Wie konnte man ein Schriftzeichen, das man nicht kennt, in einem Wörterbuch finden?

Nun, zunächst einmal sind die meisten Lexika und Wörterbücher alphabetisch nach der Romanisierung geordnet. Das heißt, alle Schriftzeichen können nach ihrer Aussprache in lateinische Buchstaben übertragen und somit alphabetisch geordnet werden. Aber das hilft uns ja immer noch nicht weiter, wenn wir die Aussprache nicht kennen, die aus den chinesischen Zeichen nicht klar ersichtlich ist. Dafür gibt es vorne einen Index. Um unser Zeichen darin zu finden, müssen wir nun das Radikal finden. Das Radikal ist eine prägnante Einheit, die oft eine Sinnkomponente des Wortes wiedergibt. Meist steht es an der linken Seite des Zeichens, aber das muss nicht immer so sein. Lernt man die chinesische Sprache und Schrift, so wird man darauf geschult, diese Radikale zu finden.
Nehmen wir nun das Zeichen . Hier ist das Radikal die linke Komponente, die angibt, dass das Zeichen etwas mit Sprache zu tun haben muss. Im Index sind zunächst die Radikale nach ansteigender Strichanzahl aufgelistet. Unser Radikal hat zwei Striche. Haben wir das Radikal nun im ersten Index gefunden, so wird uns eine Zahl angezeigt. Die Zahl bringt uns im nächsten Index zu allen Zeichen, die das Radikal enthalten. Diese sind wiederum nach Strichanzahl der restlichen Komponenten geordnet. Unsere zweite Komponente hat sechs Striche und mit dieser Info finden wir das ganze Zeichen mit der Aussprache. Unter dieser Aussprache können wir es nun im eigentlichen Wörterbuch finden.

Man sieht, das ist ein ziemlicher Aufwand, aber durch Übung wird man schneller und schneller. Außerdem hilft wie gesagt der technische Fortschritt heutzutage enorm bei der Suche nach Schriftzeichen.


Mittwoch, 20. August 2014

Das russische Alphabet und die Kyrilliza

14:14 Posted by uebersprache , , No comments
Wer sich schon einmal mit der russischen Sprache befasst hat, weiß, dass diese nicht wie die meisten europäischen Sprachen mit dem Lateinischen Schriftsystem geschrieben wird, sondern mit einem anderen, das für die slawischen Sprachen und vor allem für die Russische Sprache mit ihrem Lautinventar besser geeignet zu sein scheint. Das fällt vor allem beim Versuch russische Wörter oder Namen zu transkribieren auf.
Dieses Schriftsystem wird die „Kyrilliza“ (Кирилица) oder auch „kyrillisches Alphabet“ genannt und geht auf die „Glagoliza“ zurück, die vermutlich im 9.Jh hauptsächlich aus dem griechischen Alphabet entwickelt worden ist, um für die Christianisierung der slawischen Völker Bibeltexte im Altkirchenslawischen aufzeichnen zu können.
In der Sowjetunion wurde die Kyrilliza dann auch benutzt, um andere, nicht-slawische Sprachen aufzeichnen zu können. Daher benutzt man heute noch z. B. für das Kasachische, das Tadschikische und das Tschetschenische kyrillische Alphabete.

Aber kommen wir zurück zum russischen Alphabet:

АБВГДЕЁЖЗИЙКЛМНОПРСТУФХЦЧШЩЬЫЪЭЮЯ

Eine Besonderheit der Russischen Sprache ist, dass fast alle Konsonanten in Paaren auftreten: Zu jedem Konsonanten gibt es jeweils einen palatalisierten Partner. Das heißt, dass der Konsonant einen kleinen J-Anteil bekommt. (Wissenschaftlich ausgedrückt: der Konsonant wird palatalisiert)
Es gibt also zum Beispiel einen Laut, der ähnlich dem deutschen <t> ist, und einer, der sich fast so anhört wie ein <tj>. Am deutlichsten wird der Unterschied beim <л>, das wie ein <l> im kölnischen Dialekt ausgesprochen wird. Der Partner dazu hört sich dann ähnlich wie ein <lj> an.
Das besondere bei der russischen Schrift ist nun, dass man die palatalisierten Konsonanten genau wie ihre nicht-palatalisierten Partner schreibt.
Dass der Konsonant aber palatalisiert ist, kann man dadurch ausdrücken, dass ein sogenanntes Weichheitszeichen (ь) folgt: <л> - <ль>.
Folgt ein Vokal, so gibt es noch eine andere Möglichkeit.
Alle Vokale sind auch in Paare unterteilt. Einmal die nichtjodierten, von denen die meisten deutschen Vokalen ähnlich sind: а э ы о у
Und dann die iodierten, die ausdrücken, dass der Konsonant vorher ein palatalisierter Konsonant ist:
я е и ё ю
Anna schreibt man im Russischen so: Анна
Wollen wir das <n> aber palatalisiert haben, also Anna zu Anja machen, schreibt man hinter dem <n> nicht das normale, nichtjodierte <a> sondern das <ja> (я), das ausdrückt, dass das <n> palatalisiert ist: Аня.

Bei weiterem Interesse empfehle ich diesen Link, unter dem auch die Aussprache der Buchstaben angehört werden kann.


Lautschriften und Klassifikation von Lauten

14:08 Posted by uebersprache , , No comments
Wie schon erklärt, behandelt die Phonetik die Oberfläche der Sprache, beschreibt also die physikalisch produzierten Laute.
Wenn wir nun versuchen, alle uns bekannten Laute auszusprechen und auch noch aufzuschreiben, stoßen wir auf zwei große Probleme:

1.    Wir wissen nicht wo wir anfangen und aufhören sollen - allein in der deutschen Sprache gibt es viele verschiedene Laute, die wir gerne in eine Ordnung bringen wollen. Dazu müssen wir uns anschauen, was es für Kategorien gibt, und versuchen, all diese Laute zu klassifizieren.
2.    Wir haben erst einmal keine Möglichkeit, diese Laute distinktiv, also unterscheidend, zu notieren. Benutzen wir die deutsche Schrift dafür, fällt uns schon auf, dass z. B. der Laut, der am Ende des Wortes „Buch“ durch „ch“ wiedergegeben wird, nicht der gleiche ist, wie der, der im Wort „Bücher“ durch „ch“ wiedergegeben wird. Wir brauchen also eine allgemein gültige Lautschrift, mit der wir in der Lage sind, die verschiedenen Laute der Sprachen distinktiv zu notieren.

Wir gehen also als erstes einmal das Problem der Klassifikation an und versuchen dazu, die Phone (Laute) zu unterscheiden und Kategorien, in die wir sie einteilen können, zu finden. Zwei Hauptkategorien sind uns dabei schon aus der Schule bekannt: Vokale und Konsonanten.
Was der genaue Unterschied zwischen ihnen ist, will ich in diesem Post noch nicht verdeutlichen. Da jeder den Unterschied im Sprachgefühl beherrscht, werde ich erst einmal diese Kategorien in weitere Unterkategorien aufteilen.
Um Konsonanten grob zu beschreiben, können wir versuchen herauszufinden, wo im Mund und Rachen sie gebildet werden, wie sie gebildet werden und ob die Stimmlippen dabei mitschwingen oder nicht. Ein weiterer Post wird das noch einmal genauer unter die Lupe nehmen.
Nehmt euch zum Beispiel einmal den deutschen Konsonanten <t> und versucht, ihn zu beschreiben. Zur Frage „wo?“ also zur Frage des Artikulationsorts kann man sagen, dass er direkt hinter den Zähnen mit der Zungenspitze gebildet wird. Dieser Ort wird Zahndamm (die „Alveolen“) genannt und damit können wir diesen Laut als „alveolar“ bezeichnen. Wenn wir noch mehr deutsche Laute unter die Lupe nehmen, merken wir, dass auch die deutschen Laute <n>, <s>, <d> und <l> am gleichen Ort gebildet werden. Also sind auch diese Laute alveolar.
Auch die Vokale kann man in bestimmte Kategorien unterteilen.

Wenn dann alle Laute kategorisiert worden sind, können wir versuchen, sie in Tabellen einzutragen. Und genau das hat die „International Phonetic Association“ gemacht.
Natürlich hat sie dafür nicht die Englische oder Deutsche Rechtschreibung genommen, sondern hat jedem Laut ein eigenes Zeichen gegeben, dass universal in jedem Land gebraucht werden kann. Mit dieser Lautschrift soll jede Sprache der Welt lautlich wiedergegeben werden können.
Wer sich das einmal anschauen will, kann unter diesem Link eine PDF mit allen Zeichen bekommen. Das sieht auf den ersten Blick sehr kompliziert aus, aber wer genauer hinschaut, sieht, dass viele Zeichen der lateinischen Schrift ähnlich sind und dass das meistens genau die gleiche Schrift ist, die auch in vielen Lehrbüchern für Sprachen benutzt wird, um die Aussprache zu verdeutlichen.
Natürlich gab es auch andere Gruppierungen und Gesellschaften, die andere Lautschriften entwickelt haben, aber die sogenannte IPA hat sich am meisten durchgesetzt und wird in vielen Universitäten und auch in den meisten Lehr- und Wörterbüchern verwendet.